Backlink PDF Là Gì? Cơ Chế Googlebot Xử Lý & Truyền PageRank

Backlink PDF là siêu liên kết được nhúng trực tiếp trong văn bản tệp PDF trỏ về website mục tiêu. Googlebot thu thập tệp nhị phân này, chuyển đổi nội dung sang dạng cấu trúc HTML ảo rồi mới tính toán PageRank và xử lý liên kết. Dạng tài liệu này giúp bạn đa dạng hóa hồ sơ backlink và thu hút lượng người đọc thực tế ghé thăm website.
PDF Submission là gì? Phân biệt link trong tài liệu và link ngoài trang web
Nhiều người thường dùng lẫn lộn hai khái niệm Backlink PDF và PDF Submission, dù bản chất của chúng hoàn toàn khác nhau.
Backlink PDF là siêu liên kết nằm ngay trong nội dung tệp tin. Còn PDF Submission là thao tác Off-page SEO. Bạn tải các tài liệu giá trị như Ebook, báo cáo số liệu hay cẩm nang lên những trang chia sẻ uy tín (Scribd, SlideShare, Issuu, Academia.edu) để thu hút độc giả và nhận liên kết trỏ về.
Ngoài việc đăng lên web bên thứ ba, bạn còn có thể tự xuất bản tài liệu ngay trên website của mình (Inbound PDF Asset). Với cách này, tệp PDF hoạt động như một trang đích độc lập. Tài liệu vừa giúp bạn kiếm backlink tự nhiên khi được trích dẫn, vừa có thể lên top trực tiếp trên Google Search.
Phân biệt 2 tầng liên kết: Document Context vs Web Viewer
Khi tải tài liệu lên các nền tảng PDF Submission, trên thực tế sẽ xuất hiện hai vị trí đặt link hoàn toàn khác biệt:
| Tiêu chí so sánh | Liên kết trong tài liệu PDF (Document Context) | Liên kết ngoài trang web lưu trữ (Web Viewer Landing Page) |
|---|---|---|
| Vị trí xuất hiện | Nằm trực tiếp trong nội dung văn bản của tệp PDF | Nằm trên trang mô tả HTML hoặc trang hồ sơ tác giả |
| Định dạng kỹ thuật | Đối tượng chú thích PDF URI Annotation (ISO 32000-1) | Thẻ siêu văn bản HTML <a> thông thường |
| Thuộc tính rel | Không hỗ trợ (Googlebot theo dõi truyền PageRank) | Thường bị nền tảng gắn rel="nofollow" hoặc rel="ugc" |
| Quyền kiểm soát | Do tác giả tài liệu toàn quyền quyết định vị trí và anchor text | Do hệ thống quản trị của nền tảng lưu trữ quy định |
| Điều kiện kích hoạt | Googlebot phải lập chỉ mục chính bản thân tệp PDF | Googlebot lập chỉ mục trang web giới thiệu HTML |
3 dạng liên kết phổ biến bên trong tệp PDF
- Liên kết gắn chữ neo (Anchor Text): Chèn link trực tiếp vào từ khóa hoặc cụm từ trong đoạn văn, tương tự cách gắn link trong bài viết blog.
- Đường dẫn nguyên bản (Naked URL): Để nguyên địa chỉ web (ví dụ
https://solannseo.com) ở trang bìa, chân trang hoặc phần nguồn tham khảo. - Nút bấm kêu gọi hành động (CTA Button): Chèn link vào các ô nút đồ họa trong tài liệu. Khi độc giả nhấp vào, họ sẽ được chuyển hướng về trang web để tải tài nguyên hoặc đăng ký tư vấn.
Googlebot đọc và trích xuất liên kết trong tệp PDF như thế nào?
Googlebot không đọc tài liệu PDF bằng mắt như con người. Khi gặp một tệp PDF, hệ thống Googlebot sẽ chuyển đổi dữ liệu nhị phân sang cấu trúc văn bản gần giống HTML. Sau đó, bot mới bóc tách nội dung và ghi nhận các siêu liên kết.
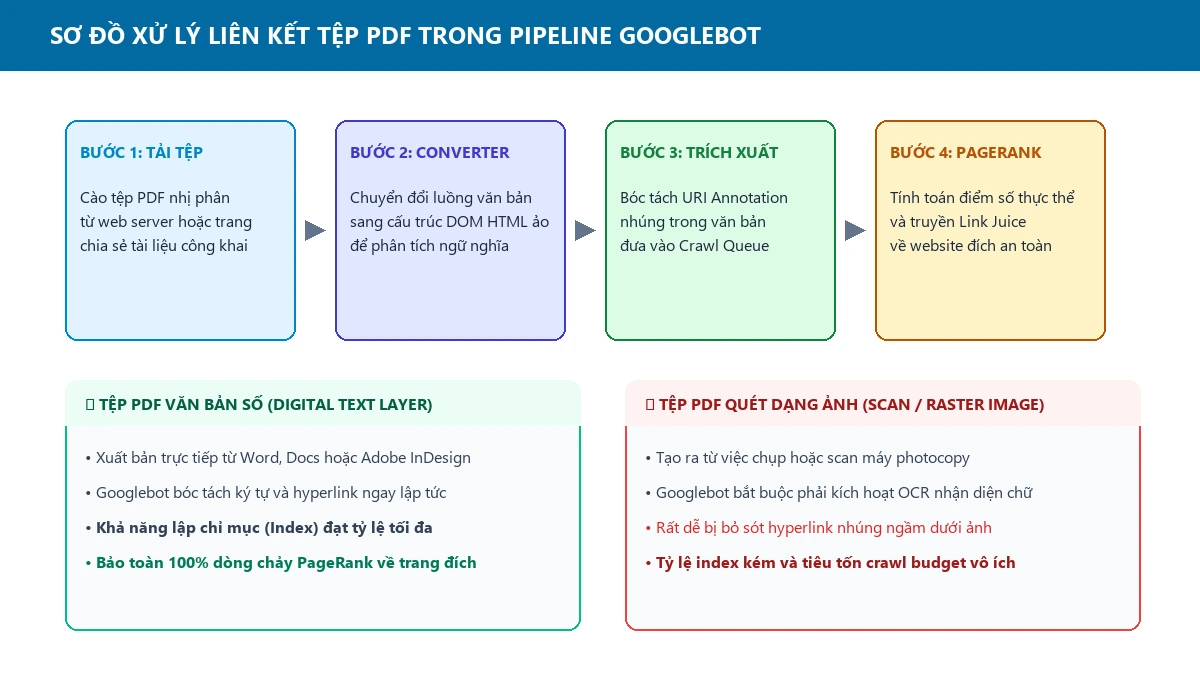
3 bước Googlebot bóc tách dữ liệu từ tệp PDF
Khi tải tệp PDF về máy chủ, Google xử lý tài liệu theo 3 bước:
- Đọc cấu trúc tệp: Bộ phân giải đọc bảng tham chiếu (Cross-Reference Table) của tệp PDF để xác định vị trí các khối ký tự và đối tượng.
- Chuyển sang cấu trúc phân cấp tương tự HTML: Hệ thống biến đổi tiêu đề, đoạn văn thành các khối nội dung có thứ bậc. Nhờ đó, bộ máy lập chỉ mục hiểu rõ ngữ cảnh của toàn bộ tài liệu.
- Đưa liên kết vào hàng đợi cào dữ liệu (Crawl Queue): Bot nhận diện các địa chỉ web nhúng trong tài liệu rồi xếp vào danh sách chờ thu thập website đích tiếp theo.
File chữ số (Text Layer) và File ảnh quét (OCR): Bot đọc loại nào tốt hơn?
Khả năng đọc hiểu của Googlebot phụ thuộc rất lớn vào cách bạn tạo ra file PDF:
Nếu bạn soạn thảo tài liệu trên Microsoft Word, Google Docs rồi xuất ra file PDF, tệp sẽ có lớp chữ số (Searchable Text Layer). Người dùng có thể bôi đen copy chữ, và Googlebot cũng đọc được văn bản lẫn liên kết ngay lập tức với độ chính xác tuyệt đối.
Trái lại, nếu bạn chụp ảnh màn hình rồi ghép thành file PDF hoặc dùng máy quét scan giấy tờ, tệp thực chất chỉ là các bức ảnh ghép lại. Dù Google có công nghệ nhận dạng ký tự quang học (OCR) để đọc chữ trong ảnh, quá trình này tốn nhiều tài nguyên và rất dễ bỏ sót các đường link nhúng ngầm.
Googlebot đọc nội dung tệp PDF với dung lượng tối đa lên đến 64MB (trong khi file HTML chỉ là 2MB). Tuy nhiên, nếu file PDF bị cài mật khẩu bảo vệ hoặc mã hóa quyền đọc, Google sẽ bỏ qua hoàn toàn và không lập chỉ mục.
Link trong file PDF là Dofollow hay Nofollow? Có truyền PageRank không?
Nhiều người làm SEO thường thắc mắc: Link trong file PDF có truyền sức mạnh thứ hạng (PageRank) không, và làm sao để cài đặt thuộc tính dofollow hay nofollow cho file?
Tệp PDF là định dạng nhị phân theo chuẩn ISO 32000-1, hoàn toàn không có thuộc tính rel của HTML. Khi tài liệu được Google lập chỉ mục công khai, bot sẽ coi các đường link này như liên kết thông thường và truyền PageRank về trang đích.
Cấu trúc liên kết nhị phân theo chuẩn ISO 32000-1
Theo đặc tả kỹ thuật quốc tế ISO 32000-1 về định dạng PDF, siêu liên kết trong tài liệu được định nghĩa dưới dạng đối tượng chú thích PDF URI Annotation (ISO 32000-1). Mã nguồn nhị phân của một liên kết PDF có cấu trúc như sau:
<<
  /Type /Annot
  /Subtype /Link
  /Rect [ 72 710 288 730 ]
  /Border [ 0 0 0 ]
  /A <<
    /S /URI
    /URI (https://solannseo.com/dich-vu-backlink-pdf)
  >>
>>
Cấu trúc này chỉ lưu tọa độ hiển thị (/Rect) và địa chỉ web đích (/URI). Trong định dạng PDF hoàn toàn không có các thẻ HTML như rel="nofollow", rel="sponsored" hay rel="ugc". Vì thế, mọi liên kết hợp lệ trong file PDF đều là liên kết tự nhiên, không bị ràng buộc bởi các thẻ hạn chế của HTML.
Xác nhận từ Google và dòng chảy Link Juice
Gary Illyes, chuyên gia phân tích tìm kiếm từ Google, từng khẳng định: Googlebot xử lý liên kết trong tệp PDF tương tự như liên kết trên trang web thông thường. Khi tài liệu được lập chỉ mục, các đường link này hoàn toàn có thể truyền dòng chảy giá trị Link Juice và tín hiệu từ khóa neo về website của bạn.
Ngoài PageRank, tài liệu PDF còn mang lại giá trị quan trọng về đồng trích dẫn (Co-citation) và đồ thị thực thể (Entity Graph). Kể cả khi độc giả không bấm vào link, Google vẫn đọc ngữ cảnh xung quanh để hiểu mối liên kết giữa thương hiệu của bạn với chủ đề chuyên môn trong tài liệu.
Trong kỷ nguyên AI Search như Google AI Overviews hay Perplexity, các mô hình này thường xuyên trích dẫn số liệu từ tệp PDF nghiên cứu và báo cáo ngành. Nhờ đó, thương hiệu của bạn có thêm cơ hội xuất hiện trực tiếp trong câu trả lời tổng hợp của AI.
rel="nofollow" là tự động xếp vào nhóm Dofollow. Do file PDF không có thuộc tính nofollow, các công cụ hiển thị Dofollow là điều hoàn toàn tự nhiên.Điều kiện bắt buộc: Vì sao tệp PDF không được Index thì giá trị bằng 0?
Để một liên kết chèn trong tệp PDF phát huy giá trị SEO thực tế, tài liệu đó bắt buộc phải đáp ứng đồng thời 3 điều kiện kỹ thuật: máy chủ lưu trữ cho phép bot thu thập dữ liệu không cần đăng nhập, tệp được Googlebot lập chỉ mục thành công và nội dung PDF có liên quan trực tiếp đến trang đích.
Quy tắc cốt tử: File chưa Index thì link chưa có giá trị
Nếu chính tệp PDF chưa được Google lập chỉ mục (Index) vào cơ sở dữ liệu tìm kiếm, thì mọi đường link trong đó đều có giá trị bằng 0 đối với thuật toán PageRank. Google không thể truyền sức mạnh từ một tài nguyên mà bộ máy tìm kiếm chưa ghi nhận.
Cạm bẫy "chặn index ngầm" bằng thẻ tiêu đề HTTP
Để tiết kiệm tài nguyên và chống spam, nhiều trang chia sẻ tài liệu vẫn cho bạn tải file lên bình thường nhưng âm thầm cài đặt dòng lệnh máy chủ:
Content-Type: application/pdf
X-Robots-Tag: noindex, nofollow
Dòng lệnh này báo cho Googlebot bỏ qua file ngay khi vừa tải về. Kết quả là tài liệu rơi vào trạng thái "Đã phát hiện - hiện chưa lập chỉ mục" (Discovered - currently not indexed), và link của bạn không bao giờ được tính điểm.
Nếu tài liệu bị chậm hiển thị trên Google, hãy xem bài hướng dẫn chẩn đoán lỗi và cách index backlink PDF.
Đánh giá hiệu quả thực tế: Khi nào nên và không nên dùng backlink PDF?
Link PDF không thể thay thế cho backlink báo chí hay các bài Guest Post chất lượng. Vai trò lớn nhất của dạng liên kết này là làm phong phú hồ sơ backlink và hỗ trợ cho các kênh liên kết chính của bạn.
3 lợi ích rõ ràng nhất khi làm link PDF
- Đa dạng hóa định dạng liên kết: Nếu hồ sơ backlink chỉ toàn bài viết web HTML, website dễ bị thuật toán nghi ngờ. Bổ sung liên kết từ tài liệu giúp hồ sơ link trông tự nhiên hơn.
- Làm đòn bẩy Tầng 2 (Tier 2) an toàn: Thay vì trỏ thẳng vào trang bán hàng nhạy cảm, bạn có thể trỏ link PDF vào các bài Guest Post hoặc PR báo chí. Cách này giúp tiếp thêm sức mạnh gián tiếp cho website một cách an toàn.
- Kéo khách truy cập thực tế (Referral Traffic): Khi bạn làm một cuốn Ebook hay hoặc báo cáo số liệu chuyên ngành, người đọc tải về máy để xem lâu dài. Nếu tài liệu thực sự hữu ích, họ sẽ bấm vào link trong file để truy cập website của bạn.
Ma trận quyết định: Khi nào nên và không nên triển khai?
| Trường hợp NÊN triển khai | Trường hợp TUYỆT ĐỐI TRÁNH |
|---|---|
| Doanh nghiệp có tài liệu nghiên cứu, Ebook, checklist, báo cáo ngành hoặc cẩm nang hướng dẫn chất lượng cao. | Dùng phần mềm tự động bắn hàng loạt file PDF rác, nội dung copy nhồi nhét từ khóa vô nghĩa. |
| Website đã có nền tảng Entity cơ bản, cần đa dạng hóa định dạng liên kết và kéo referral traffic chuyên môn. | Website mới lập chưa có nội dung gốc, dùng liên kết PDF làm nguồn backlink chính đẩy từ khóa bán hàng cạnh tranh. |
| Triển khai làm liên kết Tầng 2 (Tier 2) để tăng lực cho bài PR báo chí, Guest Post và hồ sơ thương hiệu. | Lợi dụng lỗ hổng bảo mật để cấy trộm tệp PDF lên các cổng thông tin nhà nước (GOV/EDU) nhằm trục lợi DA ảo. |
Cảnh báo thuật toán: Tránh bẫy spam link PDF
Hệ thống chống spam SpamBrain của Google hiện nay xử lý liên kết rác rất nhanh. Nếu bạn dùng phần mềm tự động xuất bản hàng loạt file PDF xào nấu, Google sẽ âm thầm vô hiệu hóa các liên kết này. Thuật toán xử lý tự động mà không cần gửi thông báo phạt thủ công.
Nghiêm trọng hơn, hành vi hack hoặc lợi dụng lỗ hổng để tải trộm file PDF lên các trang web trường học (.edu) hay cơ quan nhà nước (.gov) hiện đã bị Google trừng phạt thẳng tay thông qua chính sách Lạm dụng uy tín trang web (Site Reputation Abuse). Bạn có thể xem phân tích chi tiết tại bài viết sự thật về backlink PDF và cạm bẫy dofollow ảo.
Câu hỏi thường gặp về backlink PDF (FAQ)
Bước tiếp theo cho kế hoạch của bạn
Khi đã hiểu rõ bản chất của link PDF, bạn có thể chọn hướng đi tiếp theo tùy vào nhu cầu:
- Chọn nơi đăng tài liệu: Xem danh sách các website có chỉ số DA cao tại danh sách trang đặt backlink PDF uy tín.
- Tự tối ưu file PDF: Đọc các bước thiết lập kỹ thuật tại bài viết hướng dẫn tối ưu SEO cho file PDF.
- Học kiến thức nền tảng: Đọc thêm bài tổng quan backlink là gì và tiêu chuẩn đánh giá.
- Nếu muốn ủy thác trọn gói chuẩn SEO mũ trắng: Tham khảo giải pháp tại dịch vụ backlink PDF an toàn của Solannseo.
Trong các dự án thực tế tại Solannseo, chúng tôi không bao giờ dùng tool rải link PDF hàng loạt. Thay vào đó, chúng tôi biên soạn các bộ tài liệu chuyên ngành chỉn chu và báo cáo số liệu có ích cho người đọc. Nhờ vậy, website vừa nhận được dòng chảy PageRank sạch, vừa xây dựng được độ phủ thương hiệu uy tín mà không sợ bất kỳ đợt quét thuật toán nào của Google.