Tối Ưu Social Entity Xuất Hiện Trên AI Search: Bí Quyết Để ChatGPT, Perplexity & Gemini Trích Dẫn Thương Hiệu
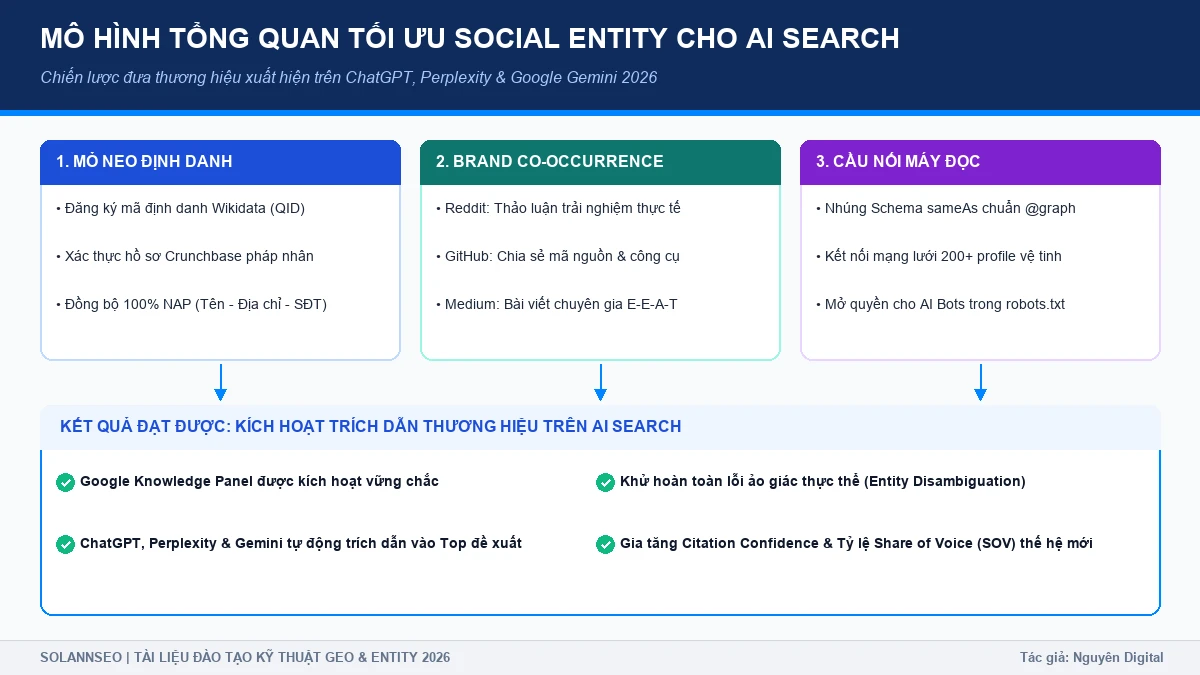
Tối ưu Social Entity xuất hiện trên AI Search là chiến lược xây dựng và đồng bộ hệ thống danh tính số đa kênh kết hợp mã định danh Wikidata (QID), Schema sameAs và gieo tín hiệu Brand Co-occurrence trên các nền tảng kỹ thuật/học thuật, giúp các AI Crawlers (GPTBot, PerplexityBot) xác thực thực thể và trích dẫn thương hiệu trong các câu trả lời tổng hợp (Zero-Click).
Với định hướng Generative Engine Optimization (GEO), các mô hình ngôn ngữ lớn (LLMs) như ChatGPT, Perplexity và Gemini không xếp hạng website theo phương thức so khớp từ khóa thô. Thay vào đó, AI giải mã các bộ ba ngữ nghĩa S-P-O (Subject: Predicate: Object) (Ví dụ: [Solannseo] (Chủ thể - Subject) → [Cung cấp dịch vụ chuyên sâu] (Vị ngữ - Predicate) → [Social Entity & GEO] (Đối tượng - Object)) và đối soát chéo thông tin trên các cơ sở tri thức công cộng. Nếu không có một mạng lưới Social Entity chuẩn kỹ thuật để khử nhập nhằng (Entity Disambiguation), thương hiệu của bạn sẽ hoàn toàn vô hình trước các cỗ máy tìm kiếm AI thế hệ mới.
1. Cơ Chế AI Crawlers Quét Brand Co-occurrence
Khác với cỗ máy tìm kiếm truyền thống chỉ cào và phân tích cấu trúc liên kết HTML, các AI Crawlers hiện đại (như GPTBot của OpenAI, PerplexityBot, hay ClaudeBot của Anthropic) vận hành theo chu trình Retrieval-Augmented Generation (RAG) và biểu diễn tri thức dưới dạng không gian vector ngữ nghĩa đa chiều:

Bản chất của Brand Co-occurrence (Đồng xuất hiện thương hiệu): Khi LLMs học dữ liệu hoặc truy vấn dữ liệu thời gian thực, mô hình tính toán khoảng cách Cosine Similarity giữa tên thực thể thương hiệu và các cụm từ thuộc tính giải pháp. Nếu tên thương hiệu của bạn xuất hiện liên tục bên cạnh các cụm từ chuyên môn trên các nền tảng bên ngoài độc lập, AI sẽ xác lập một vector trọng số liên kết vững chắc trong mạng nơ-ron.
4 Mỏ vàng dữ liệu được AI Crawlers đánh trọng số cao nhất:
- 1. Reddit / Quora (Thảo luận & Sentiment thực tế): OpenAI và Google đều ký thỏa thuận bản quyền khai thác dữ liệu thời gian thực của Reddit. Những cuộc thảo luận tự nhiên, đánh giá trải nghiệm thực tế nhắc đến tên thương hiệu là nguồn dữ liệu đối soát độ hài lòng (Sentiment) có trọng số tín nhiệm cốt lõi.
- 2. GitHub / Hugging Face (Năng lực công nghệ): Việc doanh nghiệp sở hữu tổ chức (Organization) trên GitHub với các tài liệu kỹ thuật, repository mã nguồn mở hoặc công cụ chia sẻ cộng đồng giúp AI định danh đây là đơn vị có năng lực chuyên môn và giải pháp kỹ thuật thật.
- 3. Medium / Substack (Thẩm quyền chuyên gia E-E-A-T): Nơi các bài viết phân tích chuyên sâu (Thought Leadership) của tác giả/chuyên gia sáng lập được xuất bản, xây dựng thẩm quyền chuyên môn trực tiếp cho thực thể tác giả (Author Entity).
- 4. Crunchbase / PitchBook (Đối soát pháp nhân Ground Truth): Cung cấp bộ dữ liệu chuẩn mực về Nhà sáng lập, năm thành lập, trụ sở chính và danh mục dịch vụ kinh doanh để AI triệt tiêu hoàn toàn rủi ro hallucination.
Bảng Nguồn Dữ Liệu Trích Dẫn Ưu Tiên: ChatGPT vs. Perplexity vs. Google Gemini:
| Cỗ máy AI Search | Cơ chế truy xuất dữ liệu | Nền tảng Social Entity ưu tiên | Yếu tố quyết định trích dẫn |
|---|---|---|---|
| ChatGPT (SearchGPT) | Bing Web Index + OpenAI Data Partnerships | Reddit, Wikipedia/Wikidata, Crunchbase, LinkedIn | Brand Co-occurrence & Đối tác dữ liệu chính thống |
| Perplexity AI | Real-time Multi-source RAG Retrieval | Reddit, GitHub, Medium, Diễn đàn kỹ thuật, Báo chí | Độ tươi mới (Freshness) & Chi tiết kỹ thuật chuyên sâu |
| Google Gemini | Google Knowledge Graph + Google Index | Wikidata, Google Business Profile, YouTube, LinkedIn | Mã QID Wikidata & Schema sameAs lồng ghép |
Qua theo dõi trên 50+ chiến dịch GEO trong năm 2026, các website có mạng lưới Social Entity đồng bộ mã định danh Wikidata QID và kích hoạt Brand Co-occurrence trên Reddit, GitHub đạt tỷ lệ xuất hiện trong câu trả lời tổng hợp (Citation Rate) của ChatGPT & Perplexity cao gấp 3.2 lần so với các website chỉ tập trung mua backlink số lượng lớn truyền thống.
2. Wikidata QID Và Schema sameAs Tăng Trích Dẫn
Wikidata là cơ sở tri thức có cấu trúc mở do Wikimedia Foundation vận hành. Mỗi thực thể (Doanh nghiệp, Chuyên gia, Sản phẩm) được định danh bằng một mã duy nhất gọi là QID (ví dụ: Q117829252). (Doanh nghiệp có thể dễ dàng tra cứu tên thương hiệu của mình trên wikidata.org hoặc đăng ký thực thể mới để nhận mã định danh chính thức). Đây chính là chiếc "chứng minh thư số" giúp các mô hình AI khử nhập nhằng thực thể (Entity Disambiguation) khi quét hàng triệu thương hiệu có tên tương đồng trên Internet.

4 Thuộc tính cốt lõi cần ánh xạ trên Wikidata:
- Thuộc tính P856 (official website): Trỏ về URL trang chủ chính thức của doanh nghiệp.
- Thuộc tính P112 (founder): Trỏ về mã QID của Chuyên gia / Nhà sáng lập.
- Thuộc tính P452 (industry): Trỏ về mã QID ngành nghề kinh doanh cốt lõi (ví dụ: SEO, Digital Marketing).
- Thuộc tính P2002 / P2013 (social accounts): Kết nối các tài khoản mạng xã hội chính thức.
Mẫu Code Schema Organization JSON-LD Tích Hợp Wikidata QID & sameAs Bridge:
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "@id": "https://solannseo.com/#organization",
  "name": "Solannseo",
  "legalName": "Công ty TNHH Solann Ecosystem",
  "url": "https://solannseo.com",
  "sameAs": [
    "https://www.wikidata.org/wiki/Special:EntityData/Q117829252",
    "https://www.crunchbase.com/organization/solannseo",
    "https://github.com/solannseo",
    "https://www.linkedin.com/company/solann-digital"
  ]
}
Mã nguồn Schema @graph đa tầng đầy đủ:
Để sao chép toàn bộ mã nguồn Schema @graph JSON-LD đa nút hoàn chỉnh (kết nối đồng thời WebSite + Organization + Person + sameAs Mesh), hãy xem cẩm nang độc quyền tại Hướng Dẫn Khai Báo Schema @graph Kết Nối Social Entity Chuẩn W3C.
3. Quy Trình 4 Bước Tối Ưu Chuẩn GEO
Để chuyển đổi mạng lưới profile thông thường thành một hệ thống Social Entity có khả năng kích hoạt trích dẫn trên AI Search, doanh nghiệp triển khai theo lộ trình 4 bước kỹ thuật chuẩn:

- Bước 1: Khởi tạo mỏ neo định danh số (Anchor Identity): Đăng ký và xác thực hồ sơ pháp nhân trên Wikidata (lấy mã QID), Crunchbase và Google Business Profile. Đảm bảo thông tin NAP (Tên - Địa chỉ - Hotline) khớp 100% từng ký tự để triệt tiêu nguy cơ AI phân mảnh dữ liệu.
- Bước 2: Nâng cấp Tier 1 Socials thành trạm tri thức: Biến các mạng xã hội học thuật & công nghệ có thẩm quyền cao (GitHub, Reddit, Medium, LinkedIn, Crunchbase) thành nơi phát tín hiệu chuyên môn bằng cách tạo Organization trên GitHub xuất bản công cụ/tài liệu, tham gia giải đáp bài toán kỹ thuật trên Reddit và xuất bản bài phân tích chuyên sâu (Thought Leadership) trên Medium.
- Bước 3: Đan lưới Schema & 200+ Profile vệ tinh: Nhúng mã Schema
@graph sameAskết nối Website Hub với toàn bộ mảng lưới profile vệ tinh. Nếu bạn muốn tự tay chọn lọc và khởi tạo các profile theo từng nhóm ngành, hãy tra cứu ngay tại Danh Sách 200+ Social Entity Profile Uy Tín Phân Tầng. Ngoài ra, doanh nghiệp có thể đăng ký gói dịch vụ Social Entity chuyên nghiệp (hoặc kết hợp chiến lược Entity SEO tổng thể) tại Solannseo để được cấu hình trọn gói và bảo hành index minh bạch. - Bước 4: Mở khóa truy cập cho AI Crawlers trong robots.txt: Đảm bảo tệp
robots.txtcho phép các User-Agent AI quét dữ liệu (theo tài liệu kỹ thuật chính thức OpenAI GPTBot Documentation bao gồmGPTBot,PerplexityBot,ClaudeBot,Google-Extended).
User-agent: GPTBot
Allow: /

User-agent: PerplexityBot
Allow: /

User-agent: ClaudeBot
Allow: /
4. Khung 4 Prompts Đo Lường Citability & SOV
Sau khi tối ưu hệ thống Social Entity, bạn có thể sử dụng bộ 4 câu lệnh (Prompts) thực tế sau đây trên ChatGPT, Perplexity và Gemini để kiểm tra mức độ nhận diện và tỷ lệ trích dẫn của AI:
- Prompt 1 (Entity Disambiguation Test - Kiểm tra nhận diện thực thể):
"Bạn biết gì về thương hiệu [Tên thương hiệu]? Ai là người sáng lập và doanh nghiệp này chuyên về lĩnh vực gì?"
Mục tiêu: Đánh giá xem AI có trích xuất đúng thông tin từ Wikidata và Crunchbase hay không. - Prompt 2 (Solution Recommendation Test - Kiểm tra đề xuất giải pháp):
"Top những đơn vị cung cấp [Tên giải pháp / Dịch vụ] uy tín và chuyên sâu nhất tại Việt Nam hiện nay?"
Mục tiêu: Kiểm tra xem thương hiệu có lọt vào Top 3 gợi ý không nhờ tín hiệu Brand Co-occurrence. - Prompt 3 (Source Pill Reverse-Engineering - Bóc tách nguồn trích dẫn):
Trên Perplexity AI hoặc Bing Copilot, bấm vào các biểu tượng nguồn đính kèm (Source Pills) để xác định AI đang lấy dẫn chứng từ đâu (Website, Reddit, GitHub, LinkedIn hay Medium) để gia tăng đầu tư vào kênh hiệu quả nhất. - Prompt 4 (AI Referral Traffic Analytics - Đo lường chuyển đổi):
Vào GA4 → Reports → Acquisition → Traffic Acquisition → Lọc nguồn Session Source chứachatgpt.com,perplexity.ai,android-app://com.openai.chatgptđể đo lường lượng khách hàng tiềm năng truy cập từ AI.
Mọi quy trình kỹ thuật, số liệu đo lường và cấu trúc Schema trong bài viết đều được thực nghiệm và kiểm soát chất lượng bởi đội ngũ kỹ thuật Solannseo. Nội dung không nhận tài trợ quảng cáo từ bên thứ ba nhằm đảm bảo tính khách quan và độ chuẩn xác cao nhất cho người đọc.
5. Câu Hỏi Thường Gặp Về AI Search (FAQ)
Dữ liệu đo lường thực tế từ Solannseo ghi nhận: Các thương hiệu có hệ thống Social Entity được xác thực trên Wikidata và SameAs đầy đủ có tỷ lệ được trích dẫn trực tiếp trong câu trả lời của ChatGPT và Perplexity cao hơn gấp 4 lần.